การสังเกตการณ์เอเจนต์: Hooks, Alloy และ Grafana
> เราเชื่อมต่อ Claude Code และ Codex เข้ากับ Grafana สแตกเดียวกันด้วย OpenTelemetry และ Alloy จากนั้นใช้ trace และล็อกเพื่อค้นหาและแก้ไขปัญหาพฤติกรรมของเอเจนต์ที่ต้นตอ
ระบบ agent พังในรูปแบบที่แปลกๆ
บางครั้งโมเดลคือปัญหา บางครั้งเครื่องมือคือปัญหา บางครั้ง MCP เซิร์ฟเวอร์ของคุณก็ไม่มีอะไรผิด แต่ agent เลือกผู้เชี่ยวชาญผิดคน หรือใช้เวลาครึ่งเซสชันทำงาน shell ที่คุณไม่ได้คาดคิด หรือเผาผลาญต้นทุนอย่างเงียบๆ ในลูปที่ดูมีประสิทธิผลจากภายนอก
ถ้าคุณมองไม่เห็นความแตกต่าง แสดงว่าคุณไม่ได้กำลังควบคุมระบบ agent จริงๆ คุณกำลังเดา
เราจึงสร้าง observability สแตกสำหรับเวิร์กโฟลว์ของเราเอง: Claude Code, Codex, Claude hook อีเวนต์, Codex notify อีเวนต์, OpenTelemetry แบบเนทีฟ, Grafana Alloy และ Grafana Cloud อยู่อีกฝั่งหนึ่ง
ส่วนที่น่าสนใจไม่ใช่ “เราสร้างแดชบอร์ด” ส่วนที่น่าสนใจคือเราต้องแยกเทเลเมทรีออกเป็นสองสตรีมที่ต่างกัน เพราะไม่มีฟีดเดียวที่ให้ภาพรวมทั้งหมด
ปัญหา: เทเลเมทรีของ Agent กระจัดกระจาย
agent เขียนโค้ดสมัยใหม่ปล่อยเทเลเมทรีอยู่แล้วบางส่วน สิ่งนั้นช่วยได้ แต่ไม่พอ
OTEL แบบเนทีฟเก่งในการตอบคำถามอย่าง:
- เราส่งคำขอไปกี่ครั้ง?
- เซสชันนี้มีต้นทุนเท่าไหร่?
- span และ trace อยู่ตรงไหน?
- เวลาแฝงพุ่งขึ้นหรือไม่?
แต่มันแย่กว่ามากในการตอบคำถามอย่าง:
- agent พึ่งพา MCP เซิร์ฟเวอร์ตัวไหน?
- ความล้มเหลวนี้เกิดใน
Bash, เครื่องมือไฟล์ในตัว หรือการเรียก MCP? - skill ตัวไหนที่ทำงานจริง?
- เอเจนต์ย่อยประเภทไหนที่ถูกส่งงานไป?
- เซสชันนี้กำลังทำงานที่มีประโยชน์ หรือแค่วนซ้ำอยู่กับที่?
คำถามกลุ่มที่สองนั้นอยู่ใกล้ hook มากกว่า trace
แต่ในทางกลับกันก็จริงเช่นกัน: คำถามด้านประสิทธิภาพที่สำคัญที่สุดบางข้ออยู่ใกล้ trace มากกว่า hook
ถ้าคุณอยากรู้ว่าเวลาแฝงสะสมอยู่ตรงไหนจริงๆ span ไหนที่ช้า หรือเซสชันเผาเวลาไปกับการเรียกโมเดลหรือการรันเครื่องมือ คุณต้องการข้อมูล trace เช่นเดียวกับ semantic อีเวนต์
สถาปัตยกรรมที่เราเลือกใช้
เรารันเส้นทางเทเลเมทรีสองเส้นทางคู่ขนานกัน
Claude Code
  native OTEL -> Alloy -> Grafana Cloud
  hooks        -> send_event.py -> Grafana Cloud Loki

Codex
  native OTEL -> Alloy -> Grafana Cloud
  notify hook -> codex_notify.py -> shared Loki schema
การแยกนั้นตั้งใจ
มันยังไม่สมมาตรด้วย Claude Code ให้อินเทอร์เฟซ hook ตลอดวงจรชีวิตที่หลากหลายกว่ามาก Codex ให้ OTEL แบบเนทีฟพร้อมอินเทอร์เฟซ notify ดังนั้นเรานอร์มัลไลซ์อีเวนต์การจบเทิร์นที่มีข้อมูลน้อยกว่าให้เข้ากับ schema ล็อกเดียวกัน แทนที่จะแสร้งว่าทั้งสองรันไทม์เปิดเผยการควบคุมแบบเดียวกัน
OTEL แบบเนทีฟ ให้สตรีมพื้นฐาน: ล็อกและ trace จากรันไทม์เอง บวกกับเมตริกในจุดที่รันไทม์ปล่อยจริง
Hook และ notify อีเวนต์ ให้ชั้น semantic: สิ่งอย่าง PreToolUse, PostToolUse, PostToolUseFailure, UserPromptSubmit, SubagentStop, SkillActivated และ metadata ที่จำแนกแล้ว ซึ่งเราสนใจจริงๆ เมื่อดีบักพฤติกรรม agent Claude Code ให้สตรีมอีเวนต์ที่หลากหลายกว่าตรงนี้ Codex ให้สตรีมที่นอร์มัลไลซ์แล้วซึ่งมีข้อมูลน้อยกว่าแต่ยังมีประโยชน์
เหตุใด Hook จึงมีอยู่เลย
hook pipeline ของเราเสริมอีเวนต์ก่อนที่มันจะไปถึง Loki
แทนที่จะบอกแค่ว่า “เครื่องมือหนึ่งทำงาน” เราจำแนกอีเวนต์ให้อยู่ในฟิลด์อย่าง:
tool_type: builtin, mcp, skill, agent, bashmcp_server: MCP แบ็กเอนด์ตัวไหนที่จัดการการเรียกนี้bash_cli: กลุ่มคำสั่ง shellsubagent_type: ผู้เชี่ยวชาญประเภทไหนที่ถูกส่งงานไปagent_tool: แหล่งที่มาคือ Claude Code หรือ Codex
นั่นหมายความว่าเราถามคำถามที่สำคัญในทางปฏิบัติได้:
{service_name="claude-code-hooks"} | agent_tool="codex-cli"
{service_name="claude-code-hooks"} | tool_type="mcp"
{service_name="claude-code-hooks"} | json | bash_cli="git"
ฟิลด์เหล่านั้นไม่ใช่แค่ของประดับ มันคือความแตกต่างระหว่าง “agent รู้สึกช้า” กับ “agent ใช้เวลาสิบนาทีล่าสุดไปกับงาน git ที่หนัก shell และมีอัตราความล้มเหลวของเครื่องมือสูง”
รายละเอียดการอิมพลีเมนต์หนึ่งที่ดูแปลกกว่าที่มันเป็น: Loki สตรีมที่ใช้ร่วมกันยังคงใช้ service_name="claude-code-hooks" เป็นเลเบล แม้ว่าอีเวนต์จะมาจาก Codex ก็ตาม การแบ่งจริงระหว่างรันไทม์เกิดขึ้นที่ agent_tool
เหตุใด Alloy จึงอยู่ตรงกลาง
Grafana Alloy ไม่ใช่แค่ตัวส่งต่อในการตั้งค่านี้ มันคือขอบเขตนโยบาย
เราชี้สตรีม OTEL แบบเนทีฟจาก Claude Code และ Codex ไปยัง Alloy พร็อกซีในเครื่องที่ localhost:4318 แล้วปล่อยให้ Alloy ทำความสะอาด payload ก่อนส่งต่อไปยัง Grafana Cloud
สิ่งนี้สำคัญเพราะเทเลเมทรีของ agent แบบดิบเต็มไปด้วยฟิลด์คาร์ดินาลิตีสูงที่มีประโยชน์สำหรับการวิเคราะห์ แต่แย่มากเมื่อใช้เป็นเลเบลที่ถูกทำดัชนี:
session_idprompt_id- จำนวน token
- ระยะเวลา
- ก้อนพารามิเตอร์ของเครื่องมือ
ถ้าคุณทำดัชนีทุกอย่าง จำนวนเลเบลจะพุ่งสูงจนสร้างปัญหาในการทำงาน
ดังนั้น Alloy ทำสามอย่างให้เรา:
- เก็บชุดเลเบลคาร์ดินาลิตีต่ำที่จำเป็นเพียงเล็กน้อยไว้ในดัชนี
- ย้ายฟิลด์ที่มีสัญญาณรบกวนแต่มีประโยชน์ไปยัง metadata ที่มีโครงสร้าง
- ทิ้งสัญญาณรบกวนล้วนๆ ออกไปทั้งหมด
แนวคิดสำคัญนั้นเรียบง่าย: สังเกตให้มากขึ้น ทำดัชนีให้น้อยลง
เหตุใด Hook สตรีมจึงข้าม Alloy
hook สตรีมถูกจัดรูปแบบให้ Loki อยู่แล้ว
เมื่อถึงเวลาที่ send_event.py ส่งอีเวนต์ เราตัดสินใจไปแล้วว่าฟิลด์ไหนควรได้รับการปฏิบัติแบบเลเบล และฟิลด์ไหนควรอยู่ในเนื้อหา JSON ที่มีโครงสร้าง สตรีมนั้นไปตรงยังเกตเวย์ OTLP ของ Grafana Cloud แทนที่จะผ่าน Alloy อีกรอบ
ดังนั้นระบบจึงมีการแบ่งงานที่ชัดเจน:
- Alloy จัดระเบียบสตรีม OTEL แบบเนทีฟที่ยังไม่ผ่านการปรับแต่ง
- การเสริม hook ทำให้ semantic อีเวนต์ค้นหาได้
สิ่งนี้ทำให้สถาปัตยกรรมเรียบง่ายกว่าการพยายามบังคับทุกอย่างให้ผ่านเส้นทางเดียว
แดชบอร์ดแสดงอะไรจริงๆ
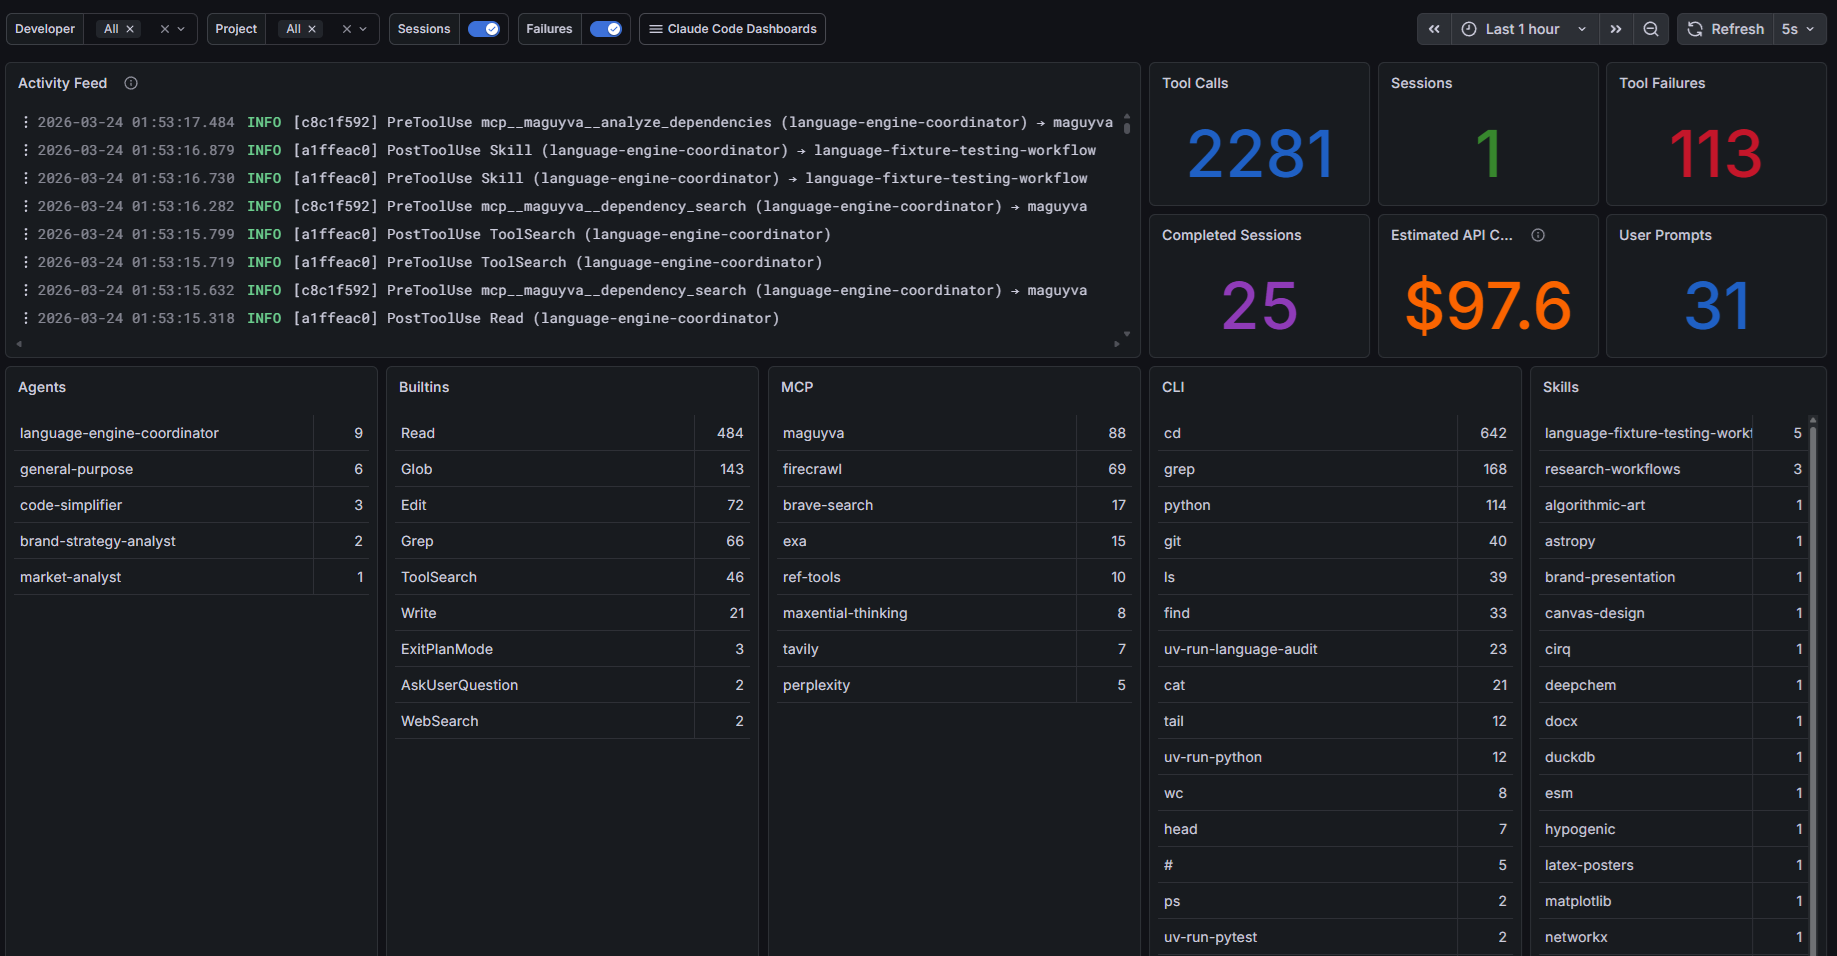
ภาพหน้าจอด้านล่างมาจากหนึ่งในแดชบอร์ด observability เบื้องหลังเวิร์กโฟลว์ agent ของเรา มันไม่ใช่ benchmark และตัวเลขเป็นแค่ภาพ ณ ช่วงเวลาหนึ่ง ประเด็นคือรูปทรงของข้อมูล: ฟีดกิจกรรม, การเรียกเครื่องมือ, ความล้มเหลว, พรอมต์ และการแยกตาม agent, เครื่องมือในตัว, การใช้ MCP, คำสั่ง shell และ skill
ส่วนที่มีประโยชน์คือแดชบอร์ดนี้อยู่บน Grafana สแตกเดียวกับ agent เทเลเมทรีที่เหลือ เราสามารถกรองตาม agent ต้นทางและกลุ่มเครื่องมือ และดูข้อมูลข้ามรันไทม์โดยไม่ต้องคิดค้นเรื่องราว observability ที่ต่างกันสำหรับแต่ละระบบ
เหตุใด Trace จึงสำคัญกว่าที่เห็นในตอนแรก
ล็อกบอกเราว่าเกิดงานประเภทไหน Trace บอกเราว่างานนั้นคลี่คลายไปตามเวลาอย่างไร
ความแตกต่างนั้นสำคัญในระบบ agent เพราะคำว่า “ช้า” นั้นทื่อเกินกว่าจะมีประโยชน์
trace สามารถบอกเราได้ว่าปัญหานั้นมาจาก:
- เวลาแฝงของโมเดล
- เวลาการรันเครื่องมือ
- การลองซ้ำซ้ำๆ
- การโต้ตอบ MCP หนึ่งครั้งที่แพงเป็นพิเศษ
- งานเล็กๆ จำนวนมากที่สะสมเวลาไว้ที่ดูไม่เป็นอันตรายเมื่อมองแยกกัน
ในทางปฏิบัติเราใช้ hook สตรีมและ Tempo trace ร่วมกัน
- ล็อกจาก hook ตอบว่า: เกิดอะไรขึ้น?
- Trace ตอบว่า: เวลาหายไปไหน?
การผสมผสานนี้คือสิ่งที่เปลี่ยน observability จากแดชบอร์ดให้กลายเป็นคำอธิบาย
Codex เข้ามาตรงไหน
Codex เป็นส่วนหนึ่งของสแตกเดียวกัน แต่ไม่เหมือนกับ Claude Code เสียทีเดียว
สำหรับ Codex เราเชื่อมสองส่วน:
- OTEL แบบเนทีฟจาก Codex เข้าสู่ Alloy
- notify webhook เข้าสู่
codex_notify.pyซึ่งแมปการจบเทิร์นให้เข้ากับ Loki schema เดียวกับที่เราใช้กับ hook อีเวนต์
นั่นทำให้เรามีตัวกรองรวมอย่าง agent_tool="codex-cli" ภายในสตรีมล็อกเดียวกัน
ข้อแม้ที่ตรงไปตรงมา: payload notify ของ Codex ในตอนนี้บางกว่า payload hook ของ Claude Code เพราะมันไม่ใช่อินเทอร์เฟซการผสานรวมแบบเดียวกัน ในระบบของเราวันนี้ การจบเทิร์นของ Codex สามารถถูกนอร์มัลไลซ์ให้เข้ากับ schema ที่ใช้ร่วมกันได้ แต่การดึงข้อมูลระดับเครื่องมือ ทีละตัวยังคงดีกว่าใน OTEL สตรีมแบบเนทีฟ มากกว่าใน notify บริดจ์
เราไม่ได้ยกข้อจำกัดนี้มาเป็นข้อแก้ตัว มันคือประเด็นของบทความนี้ ระบบ observability จริงถูกประกอบขึ้นจากสัญญาณที่ไม่สมบูรณ์แบบ
Grafana ผ่าน MCP เปลี่ยนเกม
การเปลี่ยนแปลงที่ใหญ่กว่าคือ Grafana ไม่ได้เป็นแค่สถานที่ที่มนุษย์เข้าไปดูในเบราว์เซอร์อีกต่อไป
ในรีโพนี้เรายังเปิด Grafana ผ่าน MCP ด้วย นั่นหมายความว่า agent สามารถคิวรี Loki, Prometheus และ Tempo ได้โดยตรง แทนที่จะรอให้มนุษย์ตรวจแดชบอร์ดด้วยมือก่อน
นั่นเปลี่ยน observability ให้กลายเป็นข้อมูลนำเข้าที่ช่วยขับเคลื่อนเวิร์กโฟลว์
agent สามารถถามได้ว่า:
- กลุ่มเครื่องมือไหนล้มเหลวมากที่สุดในชั่วโมงที่ผ่านมา?
- MCP เซิร์ฟเวอร์ตัวไหนครองเซสชันนี้?
- การเปลี่ยนแปลงล่าสุดลดความล้มเหลวของเครื่องมือลงจริงหรือแค่ย้ายงานไปยังเส้นทางที่หนัก shell มากขึ้นด้วยความผิดพลาดแบบเดิม?
- trace ไหนแสดงเวลาแฝงสูงสุดหรือการลองซ้ำซ้ำๆ?
เมื่อคุณมีสิ่งนั้นแล้ว คุณก็ใกล้เข้าไปยังลูปการปรับปรุงตัวเองมาก
จากแดชบอร์ดสู่ลูปป้อนกลับ
นี่คือส่วนที่เราพบว่าน่าสนใจที่สุด
เมื่อ observability สแตกค้นหาได้จากชั้น agent แล้ว เทเลเมทรีจะหยุดเป็นเครื่องมือรายงานที่รอให้คนเข้ามาดู และกลายเป็นสัญญาณควบคุม
ลูปหน้าตาแบบนี้:
- กิจกรรมของ agent ปล่อย trace, เมตริก และล็อกจาก hook ที่เสริมแล้ว
- Grafana เก็บหลักฐานไว้ใน Loki, Tempo และ Prometheus ในจุดที่มีเมตริก
- agent คิวรีหลักฐานนั้นผ่าน Grafana MCP
- ระบบระบุส่วนผสมเครื่องมือที่ไม่ดี skill ที่เปราะบาง การจัดเส้นทางที่อ่อนแอ หรือเวิร์กโฟลว์ที่หนัก shell ซึ่งยังคงก่อความผิดพลาดที่หลีกเลี่ยงได้
- agent หรือผู้ควบคุมปรับพรอมต์, การตั้งค่าของ agent, คำอธิบาย skill, กฎการจัดเส้นทาง หรือสิทธิ์เข้าถึงเครื่องมือ
- เซสชันถัดไปสร้างรูปทรงเทเลเมทรีใหม่ และวงจรก็ทำซ้ำ
นั่นคือวิธีที่คุณเคลื่อนจาก “แดชบอร์ดที่น่าสนใจ” ไปสู่ “ระบบปรับปรุงที่วัดผลได้”
เป้าหมายไม่ใช่การเพิ่มการใช้เครื่องมือประเภทเดียวให้สูงสุด แต่คือการลงเอยที่ส่วนผสมที่เหมาะสมของ CLI, เครื่องมือในตัว, การเรียก MCP และ skill สำหรับงานที่กำลังทำอยู่จริง
สิ่งนี้ช่วยให้เราตอบอะไรได้
เมื่อทั้งสองรันไทม์ลงเอยใน Grafana สแตกเดียวกัน เราตอบคำถามเชิงปฏิบัติการได้เร็วขึ้นมาก:
- ความล้มเหลวกระจุกตัวอยู่ในกลุ่มเครื่องมือเดียวหรือไม่?
- เวิร์กโฟลว์ที่หนัก shell กำลังสร้างความผิดพลาดที่หลีกเลี่ยงได้ ในจุดที่ควรมีเครื่องมือระดับสูงกว่าอยู่หรือไม่?
- MCP เซิร์ฟเวอร์ตัวไหนแบกรับภาระงาน?
- เรากำลังจ่ายเงินสำหรับกิจกรรม agent ที่ไม่ได้สร้างความคืบหน้าที่มีความหมายอยู่หรือไม่?
- เซสชันหนึ่งไม่แข็งแรงเพราะโมเดล เครื่องมือ หรือชั้นออร์เคสเตรชัน?
สิ่งนี้มีประโยชน์เป็นพิเศษในเวิร์กโฟลว์แบบหลาย agent ที่คำว่า “agent กำลังยุ่งอยู่” แทบไม่บอกอะไรคุณเลย
ถ้าผู้เชี่ยวชาญตัวหนึ่งถูกส่งงานซ้ำๆ และสร้างอัตราความล้มเหลวสูง นั่นคือปัญหาการจัดเส้นทางหรือการปรับพรอมต์
ถ้า MCP เซิร์ฟเวอร์ตัวหนึ่งครองการเรียกทั้งหมด นั่นอาจเป็นสถาปัตยกรรมที่ดี หรือเป็นสัญญาณว่าส่วนอื่นทั้งหมดเป็นส่วนเกินที่ไม่มีประโยชน์
ถ้าความล้มเหลวของเครื่องมือพุ่งขึ้นในขณะที่ต้นทุนยังสูงอยู่ คุณมีปัญหาเชิงปฏิบัติการ ไม่ใช่ปัญหาคุณภาพ
ถ้างาน shell ยังคงล้มเหลวในรูปแบบที่คาดเดาได้และหลีกเลี่ยงได้ ในจุดที่ควรมีเครื่องมือระดับสูงกว่า นั่นคือสัญญาณของผลิตภัณฑ์
ถ้า skill หนึ่งทำงานตลอดเวลาแต่ไม่ได้ปรับปรุงผลลัพธ์ นั่นคือสัญญาณของพรอมต์หรือการจัดเส้นทาง
บทเรียนที่แท้จริง
บทเรียนที่ลึกกว่านี้คือ agent observability ต้องการทั้ง เทเลเมทรีรันไทม์ และ เทเลเมทรีเวิร์กโฟลว์
เทเลเมทรีรันไทม์บอกคุณว่าระบบทำอะไร
เทเลเมทรีเวิร์กโฟลว์บอกคุณว่า agent คิดว่าตัวเองกำลังทำอะไร
เราต้องการทั้งสองอย่าง
ถ้าคุณเก็บแค่ trace และตัวนับ คุณจะพลาดชั้น semantic ถ้าคุณเก็บแค่ hook อีเวนต์ คุณจะพลาดเวลาแฝง, span และภาพรวมรันไทม์
และถ้าคุณเก็บทั้งสองอย่างแต่ไม่เคยป้อนกลับเข้าสู่ชั้น agent คุณก็มีแค่การมอนิเตอร์ ไม่ใช่การปรับตัว
การผสมผสานนี้คือสิ่งที่ทำให้ระบบอธิบายได้พอที่จะควบคุม และปรับได้พอที่จะปรับปรุง
สิ่งที่ยังไม่สมบูรณ์แบบ
ยังมีบางส่วนที่ต้องปรับปรุง
- hook อีเวนต์ไม่ทุกตัวรวมข้อมูลระยะเวลาและ token ที่เราต้องการ
- มุมมองด้านการจับเวลาที่ดีที่สุดบางส่วนยังคงมาจาก Tempo trace ไม่ใช่ล็อกจาก hook
- Codex ในวันนี้มี semantic น้อยกว่า Claude Code ในสตรีมอีเวนต์ที่เสริมข้อมูลแล้ว
- ภาพหน้าจอแดชบอร์ดเป็นหน้าจอที่ใช้ในการปฏิบัติงานจริง ไม่ใช่ผลงานการตลาดที่ขัดเกลาแล้ว
ประเด็นสุดท้ายนั้นตั้งใจ เราอยากแสดงแผงเครื่องมือจริงมากกว่าจะแสร้งว่าระบบ agent อธิบายตัวเองได้อย่างน่าอัศจรรย์
เหตุใดสิ่งนี้จึงสำคัญสำหรับ Maguyva
Maguyva คือการมอบโค้ดอินเทลลิเจนซ์ที่ดีกว่าให้ agent แต่เมื่อ agent ทำงานที่มีประโยชน์จริงๆ แล้ว ความต้องการใหม่ก็ปรากฏขึ้นทันที: คุณต้องเห็นว่าพวกมันมีพฤติกรรมอย่างไร
คุณภาพการค้นหา คุณภาพการจัดเส้นทาง การเลือกเครื่องมือ และประสิทธิภาพของบริบท ล้วนกลายเป็นปัญหาที่สังเกตได้
นั่นคือเหตุผลที่เราคิดว่านี่คุ้มค่าที่จะเขียนถึง agent สแตกแห่งอนาคตไม่ใช่แค่พรอมต์และเครื่องมือ มันคือพรอมต์ เครื่องมือ และชั้นอินสทรูเมนเทชันที่บอกคุณว่าทั้งหมดกำลังทำงานหรือไม่
ถ้าคุณกำลังสร้างเวิร์กโฟลว์ agent อย่างจริงจัง observability ไม่ใช่โครงสร้างพื้นฐานที่เลือกได้ มันคือส่วนหนึ่งของผลิตภัณฑ์
อ่านเพิ่มเติมที่เกี่ยวข้อง
เนื้อหาอื่นๆ จากบันทึกการพัฒนา Maguyva
ขุดค้นและปิดวงจร: การเปลี่ยนแปลงกลายเป็นความทรงจำองค์กรได้อย่างไร_
Git commit กลายเป็นรายการบันทึกการเปลี่ยนแปลงที่มีโครงสร้างและบันทึกการตัดสินใจเชิงสถาปัตยกรรม แล้วป้อนกลับเข้าสู่เอเจนต์ AI ในรูปแบบความทรงจำองค์กรที่ค้นหาได้
การขุดค้น Skill: จาก 3,500 รายการที่เข้าข่ายสู่ 466 ความสามารถ_
เราคัดกรอง skill ที่เข้าข่าย 3,500 รายการ และรับเข้าใช้งาน 466 รายการ ลูปการขุดค้นและนำเข้าอย่างเป็นระบบ เพื่อสร้างคลัง skill ของ AI agent ที่สอดคล้องกันในระดับใหญ่
Ground Truths: ยึดโยง AI Agent ไว้กับความเป็นจริง_
AI agent หลอนได้อย่างมั่นใจ Ground Truths คือข้อเท็จจริงที่มีเวอร์ชันและขอบเขตชัดเจน ซึ่งยึดโยงพฤติกรรมของ agent ไว้กับความเป็นจริง นี่คือวิธีที่เราสร้างและบังคับใช้มัน